Getting Started with Apache Spark on Kubernetes
Learn to deploy and optimize Apache Spark on Kubernetes with hands-on demos, covering environment setup, application sizing, performance tuning, and monitoring for efficient data pipeline management.
Delta Lake: Optimizing Merge Operations
Explore Delta Lake merge optimization techniques, including inner and full outer joins, partition pruning, and file pruning. Learn tips for handling large merges efficiently.
Building a Cloud Data Lake with Databricks and AWS - Best Practices and Implementation
Explore building a cloud data lake using Databricks and AWS. Learn about data lake architecture, AWS services, Delta Lake for reliability and performance, and best practices for implementation.
Stateful Streaming with Apache Spark - Updating Decision Logic at Runtime
Learn how to implement stateful streaming with Spark, focusing on updating decision logic at runtime for real-time offer personalization in loyalty programs like PAYBACK.
Leveraging Apache Spark and Delta Lake for Efficient Data Encryption at Scale
Efficient data encryption solution for privacy compliance using Apache Spark and Delta Lake. Automates consumer deletion requests, enhances security, and maintains data integrity while ensuring accessibility when needed.
Common Strategies for Improving Performance on Delta Lakehouse
Explore techniques to enhance Delta Lakehouse query performance, including data skipping, optimizing Z-Order, SQL partitions, and Delta Cache. Learn to analyze and tune queries for better results.
Diving into Delta Lake: Understanding the Transaction Log
Explore Delta Lake's transaction log: its structure, functionality, and role in ACID transactions, metadata handling, time travel, and concurrent operations. Gain insights into this core component.
Optimizing Geospatial Queries with Dynamic File Pruning in Databricks Delta
Optimize geospatial queries using z-ordering and dynamic file pruning techniques in Databricks Delta, significantly improving query times for petabyte-scale data through specific data generation and SQL query design strategies.
Demystifying Delta Lake - Data Reliability for Data Lakes
Explore Delta Lake's reliability features for data lakes with Apache Spark creator Michael Armbrust. Learn about ACID transactions, metadata handling, and unified data processing.
SQL Analytics and the Lakehouse Architecture - Data + AI Summit EU 2020 Keynote
Explore lakehouse architecture, Delta Lake, and SQL Analytics for unified data management. Learn how this approach combines data warehouse capabilities with data lake flexibility, enabling faster analytics and decision-making.
How Apache Spark 3.0 and Delta Lake Enhance Data Lake Reliability
Explore Apache Spark 3.0 and Delta Lake's enhancements for data lake reliability, including ACID transactions, schema enforcement, and time travel. Learn about performance improvements and new features in Databricks Runtime 7.0 Beta.
Fugue: Unifying Big Data Analytics Ecosystems for ETL and Machine Learning
Unifying big data ecosystems with Fugue: SQL-like framework for ETL and ML pipelines, compatible with Spark, TensorFlow, and more. Simplifies development, improves performance, and enhances maintainability.
Presto on Apache Spark - A Tale of Two Computation Engines
Explore the integration of Presto and Spark, combining low-latency evaluation with robust execution for enhanced SQL experience in both interactive and batch use cases at Facebook scale.
Designing the Next Generation of Data Pipelines with Apache Spark - Zillow's Approach
Zillow's data engineering team shares their journey in redesigning data pipelines using Apache Spark, focusing on scalability, maintainability, and robustness while reducing code complexity.
Simplify and Boost Spark 3 Deployments with Hypervisor-Native Kubernetes
Explore integrating Spark 3 with VMware Pacific for scalable, reliable, and high-performance big data analytics deployments using hypervisor-native Kubernetes on vSphere 7.
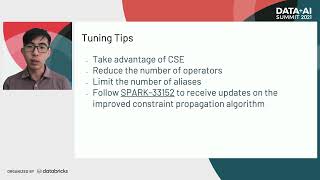
Optimizing Catalyst Optimizer for Complex Spark Plans
Optimizing Spark's Catalyst optimizer for complex plans with thousands of operators and large case statements. Techniques include memory-efficient logging, subexpression elimination, and improved constraint propagation.
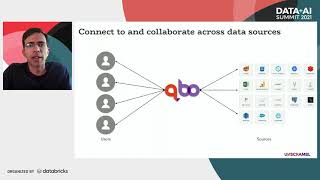
Natural Language Query and Conversational Interface to Apache Spark
Explore conversational analytics with Apache Spark, enabling natural language queries for data insights. Learn about NLP-to-SQL translation and its integration with dialog management and visualization.
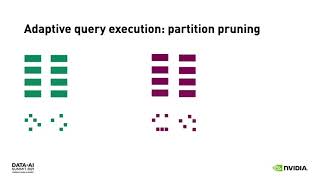
Modernizing Apache Spark 3.0 Applications - Best Practices and Optimization Techniques
Optimize legacy Spark applications for 3.0: leverage Adaptive Query Execution, columnar processing, GPU acceleration, and ML integration. Concrete examples and lessons from modernizing analytics workloads.
Learn to Use Databricks for Data Science
Discover how Databricks simplifies data science with a unified platform for analytics workloads, from data preparation to predictive analytics, enhancing collaboration and productivity at scale.
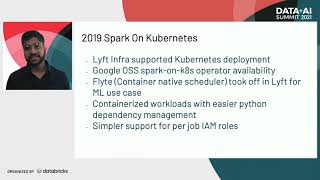
Hybrid Apache Spark Architecture: Optimizing YARN and Kubernetes for Lyft's Workloads
Explore Lyft's hybrid Apache Spark architecture using YARN and Kubernetes, addressing scalability challenges and optimizing workload management for improved reliability and efficiency.
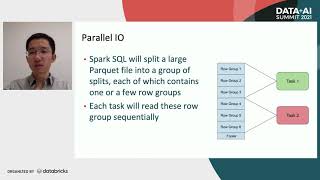
Optimizing Spark SQL Jobs with Parallel and Asynchronous IO
Optimizing Spark SQL jobs through parallel and async IO techniques, including file-level and row group-level parallel read, asynchronous spill, and parquet column family, resulting in 5-30% performance improvement.