Multi-Agent Dynamics with Self-Play Reinforcement Learning
Explore how self-play techniques in multi-agent reinforcement learning revolutionize game theory, enabling AI agents to develop advanced strategies through autonomous learning and competition.
Behavior Cloning and Residual Reinforcement Learning for Visual Assembly
Explore advanced imitation learning techniques combining behavior cloning with reinforcement learning for autonomous robotic systems, focusing on precise visual assembly and sim-to-real transfer applications.
Reinforcement Learning-Based Fine-Tuning of Diffusion Models for Drug Discovery
Dive into advanced reinforcement learning techniques for fine-tuning diffusion models, focusing on accelerated drug discovery, bioinformatics, and molecular compound predictions.
Multi-Agent AI Coordination and Pathfinding Using Cooperative Reward Shaping
Discover how multiple AI agents coordinate actions through Reinforcement Learning, from pathfinding algorithms to practical applications in transport, underwater networks, and space exploration.
Coding Multi-Agent Reinforcement Learning with PyTorch and JAX - Including ReDel and AgentScope Frameworks
Dive into practical multi-agent reinforcement learning implementation using PyTorch and JAX, featuring new frameworks ReDel and AgentScope for advanced distributed systems and LLM-powered simulations.
Understanding Q* (Q-star) - From Q-Learning to Maximum Entropy Reinforcement Learning
Delve into the technical foundations of Q* (Q-star), exploring its roots in physics entropy, reinforcement learning principles, and practical applications in machine learning systems.
Robotics Policy Optimization for Multi-Agent Drone Swarms Using Game Theory
Explore advanced reinforcement learning applications in optimizing taxi fleets and drone swarms, focusing on multi-agent systems and environmental interaction strategies.
Sample-Efficient Constrained Reinforcement Learning with General Parameterized Policies
Delve into advanced reinforcement learning concepts with Dr. Mondal as he explores sample-efficient algorithms for Constrained Markov Decision Processes, focusing on parameterized policies and practical applications.
Towards a Theory of Exploration in Continuous-Time Reinforcement Learning
Delve into advanced theoretical frameworks for continuous-time reinforcement learning, exploring relaxed controls and rough path theory for modeling exploration processes in stochastic environments.
Average Reward Markov Decision Process - Policy Gradient Algorithms and Regret Analysis
Delve into infinite horizon average reward Markov Decision Process (MDP), exploring policy gradient algorithms, gradient estimation techniques, and innovative approaches to reduce mixing time dependencies.
Adaptive Multi-armed Bandit Algorithms for Markovian and IID Rewards
Explore adaptive multi-armed bandit algorithms and their applications in both Markovian and i.i.d reward scenarios, focusing on regret guarantees and novel algorithmic approaches.
Almost-Optimal Best Restless Markov Arm Identification with Fixed Confidence
Delve into advanced multi-armed bandit theory, focusing on identifying optimal arms in restless Markov chains through asymptotic analysis and policy optimization for distributed learning systems.
Finite Time Analysis of Temporal Difference Learning with Linear Function Approximation: Tail Averaging and Regularization
Delve into advanced temporal difference learning analysis, exploring tail-averaging techniques and regularization methods for improved convergence rates in reinforcement learning applications.
Mean-Field Control for Restless Bandits and Weakly Coupled MDPs
Explore optimization methods and stochastic models for large-scale system control, focusing on mean-field approaches to overcome dimensionality challenges in reinforcement learning and resource allocation.
Adapting Image-based Reinforcement Learning Policies via Predicted Reward Fine-Tuning
Explore groundbreaking research on Predicted Reward Fine-Tuning (PRFT), a novel approach solving domain shift challenges in image-based reinforcement learning and sim-to-real AI transfer.
Deep Learning: Deep Reinforcement Learning and Policy Gradients - Lecture 13
Dive into advanced deep reinforcement learning concepts including policy gradients, REINFORCE algorithm, and their applications in Atari games and Go, taught by Ali Ghodsi.
Deep Learning: Introduction to Reinforcement Learning and Policy Iteration - Lecture 12
Dive into reinforcement learning fundamentals, exploring policy iteration, value iteration, Markov decision processes, and Monte Carlo estimation techniques for advanced AI applications.
Using Machine Learning for Doing Rather Than Knowing - Practical Applications of RL in Industry
Explore practical applications of reinforcement learning in industrial systems, focusing on real-time control algorithms for supply chains, logistics, and energy management in non-stationary environments.
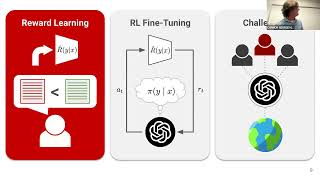
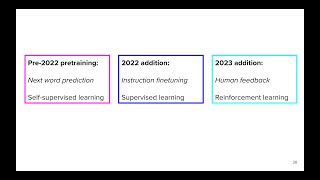
Reinforcement Learning from Human Feedback (RLHF) - Advances in Generative AI
Dive into reinforcement learning from human feedback (RLHF) and its crucial role in advancing generative AI systems, exploring key concepts, implementation strategies, and real-world applications.
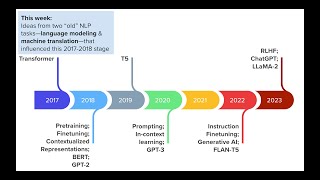
Introduction to Language Modeling: From N-grams to Neural Networks
Explore the evolution of language modeling, from n-grams to neural architectures, covering key concepts like embeddings, transformers, and RLHF implementations.
Finetuning a Sequence-to-Sequence Model with RLHF
Master sequence-to-sequence model finetuning techniques and reinforcement learning from human feedback (RLHF) through hands-on demonstrations and practical implementations.