Solving High-Dimensional Optimal Control Problems with Empirical Tensor Train Approximation
Explore innovative approaches to solve high-dimensional optimal control problems using Tensor Train approximation, with applications to destabilized viscous Burgers and diffusion equations.
Understanding Q* (Q-star) - From Q-Learning to Maximum Entropy Reinforcement Learning
Delve into the technical foundations of Q* (Q-star), exploring its roots in physics entropy, reinforcement learning principles, and practical applications in machine learning systems.
Introduction to Reinforcement Learning
Learn reinforcement learning fundamentals and apply them to solve control problems using Python libraries. Hands-on training with cartpole example and challenge to tackle inverted pendulum problem.
CS885 - Semi-Markov Decision Processes
Explore semi-Markov decision processes, reinforcement learning, and queueing theory. Learn about Bellman's equation and the option framework for advanced decision-making strategies.
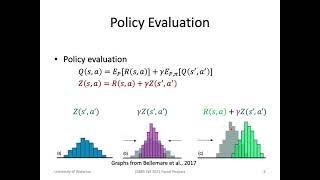
Distributional RL
Explore distributional reinforcement learning, covering return distribution, policy evaluation, and the C51 algorithm, with insights into its advantages and applications in Atari games.
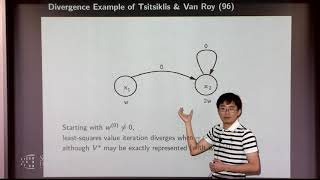
Reinforcement Learning via an Optimization Lens
Explore reinforcement learning through an optimization lens, covering MDPs, Bellman equations, and novel approaches to solving RL problems using linear programming and primal-dual formulations.
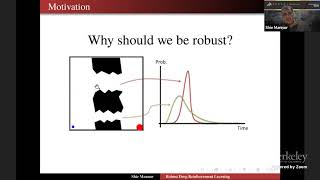
Deep Robust Reinforcement Learning and Regularization
Explore robust reinforcement learning, addressing uncertainties in deep RL through regularization techniques. Gain insights into robust MDPs, policy evaluation, and uncertainty-aware Bellman equations.
Online Learning in Markov Decision Processes - Part 1
Explore online learning in Markov Decision Processes, covering theory, algorithms, and optimal strategies for reinforcement learning in dynamic environments.
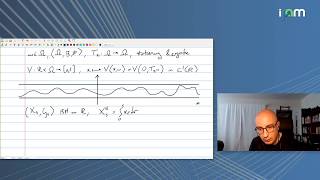
Nonconvex Homogenization for 1D Controlled Brownian Motion in a Random Potential
Explores stochastic control of Brownian motion in random potentials, analyzing optimal payoff growth and Bellman equation homogenization. Discusses effective Hamiltonians and distinct control regimes.
Q-Learning: From Basics to Deep Q-Networks
Explore Q-Learning fundamentals, from Markov Decision Processes to Deep Q-Networks, in this comprehensive overview of reinforcement learning concepts and applications.
A Friendly Introduction to Deep Reinforcement Learning, Q-Networks and Policy Gradients
Friendly exploration of deep reinforcement learning concepts, including Markov decision processes, Q-networks, and policy gradients, using examples and visuals to explain complex ideas.
Intro to Artificial Intelligence - Markov Decision Process (MDP) - Lecture 17
Explore Markov Decision Processes (MDPs) in AI, learning algorithmic techniques for modern problem-solving in uncertain environments.