Charlas- Introducción a FastAPI
Descubre cómo crear APIs rápidas y eficientes con FastAPI. Aprende validación automática, documentación basada en estándares y alto rendimiento, todo explicado de manera accesible y con ejemplos prácticos.
Unlocking Heterogeneous AI Infrastructure K8s Cluster: Leveraging the Power of HAMi
Explore HAMi project for managing diverse AI devices in K8s clusters. Learn unified scheduling, GPU sharing, flexible policies, and real-world case studies to optimize heterogeneous AI infrastructure.
Demistificando el Undefined Behaviour en Compiladores
Explicación detallada del "Undefined Behaviour", su propósito, diferencias con "Unspecified Behaviour" y su aprovechamiento en optimizaciones de compiladores para código de alto rendimiento.
DFT on Expensive GPU-based Supercomputer
Explore advanced density functional theory computations using high-performance GPU supercomputers for cutting-edge quantum chemistry research.
VeScale - A PyTorch Native LLM Training Framework for Automatic Parallelism
探索PyTorch原生框架veScale,实现大规模语言模型的自动并行训练。结合易用性和性能,助力开发者高效扩展LLM训练,无需复杂并行编程。
Constructing the 10x Efficiency of Cloud-Native AI Infrastructure
Explore strategies to maximize GPU utilization, unify accelerators, manage resources, and optimize AI infrastructure for 10x efficiency in cloud-native environments.
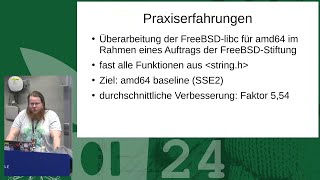
Textverarbeitung mit SIMD-Techniken - Effiziente Stringverarbeitung für moderne Anwendungen
Effiziente Textverarbeitung mit SIMD-Techniken: Beschleunigung von String-Operationen durch parallele Verarbeitung mehrerer Zeichen gleichzeitig, für optimierte Leistung in modernen Anwendungen.
Komischen Code schreiben der schnellen Code schreibt - Algorithmen-Varianten in High-Performance Anwendungen
Optimierung von Performance-kritischem Code: Vergleich von Algorithmen-Varianten, Zero-Cost Abstractions und innovative Lösungsansätze für High-Performance-Anwendungen in C++.
Boosting LLM Development and Training Efficiency: Automated Parallelization with MindSpore
Explore automated parallelization for efficient LLM development and training using MindSpore. Learn to optimize distributed training on large-scale clusters without intrusive model modifications, accelerating AI research and implementation.

Introduction to CUDA Programming for Physicists - Lecture 1
Explore CUDA programming fundamentals for physicists, covering essential concepts and techniques to leverage GPU computing in scientific applications.
Instalación de Nvidia Cudnn y Primeros Pasos con NVCC en C++
Aprende a instalar Cudnn, la biblioteca de redes neuronales profundas de CUDA, y comienza a desarrollar aplicaciones de aprendizaje automático con soporte GPU en C++.
AirLLM: Inferencia de LLM de 70 Billones de Parámetros en GPU de 4GB - Español
Aprende a realizar inferencia con un LLM de 70 billones de parámetros en una GPU doméstica de 4GB usando AirLLM. Explora técnicas avanzadas de machine learning y optimización de recursos.
Acelere su Código Python con Numba y Cupy
Acelera tu código Python utilizando Numba y Cupy: compila y mueve a la GPU para optimizar el rendimiento en machine learning y ciencia de datos.
Rapids Machine Learning Training y Feature Engineering en tu GPU con CuML y CuDF
Acelera el entrenamiento de modelos y la ingeniería de características utilizando GPU con CuML y CuDF para optimizar tus flujos de trabajo de aprendizaje automático.
Pandas Transformaciones en Paralelo con Dask y Pandarallel
Optimiza transformaciones de datos con Dask y Pandarallel para procesamiento paralelo eficiente en Pandas, mejorando el rendimiento en grandes conjuntos de datos.
China Mobile Wutong Cloud Native Analytical Database Architecture
Explore China Mobile's Wutong Cloud Native Analytical Database architecture, designed for large-scale, elastic, high-performance, and cost-effective data warehousing in cloud environments.
Genus de Grafos de Pancakes y Pancakes Quemados: Cotas Superiores e Inferiores
Explora cotas superiores e inferiores para el genus de grafos de pancakes y sus aplicaciones en bioinformática y computación paralela, utilizando sistemas de rotaciones y técnicas de permutación.
Introduction to CUDA Programming for Physicists - Lecture 4
Explore advanced CUDA concepts for physicists: reduction operations, specialized libraries, and optimizing GPU-accelerated computations for scientific applications.
Creating Intelligent Machines with the Isaac SDK - NVIDIA Webinar
Learn to program, simulate, and deploy robotic applications using NVIDIA's Isaac SDK. Covers codelets, compute-graphs, simulation testing, and Jetson deployment, with hands-on examples and Q&A.
Digital Twins: How High-Performance Computing Drives Personalized Models
Explore digital twins in engineering, geosciences, and medicine. Learn about high-performance computing's role in creating virtual replicas for predictive maintenance and personalized healthcare decisions.
Adventures in Reviewing Mountains of Code
Explore strategies for efficiently reviewing large codebases, including experiments, tools, and unexpected challenges encountered during a 2.6 million line code assessment.