Information Retrieval in the Era of Large Language Models
Explore how large language models are transforming information retrieval systems, with focus on event detection, clinical data extraction, and social media analysis for epidemic prediction.
Making RAG Work - Building Robust Retrieval Augmented Generation Systems
Dive into practical techniques for implementing robust RAG systems, exploring common pitfalls, optimization strategies, and design principles for production-ready LLM applications.
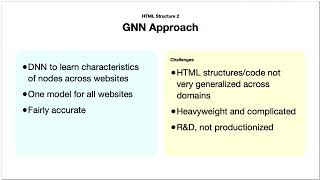
Web Extraction with Large Language Models - Lessons from Parsing Billions of Webpages
Discover cutting-edge techniques for web scraping and data extraction using Large Language Models, drawing from Pinterest's experience of parsing billions of webpages daily.
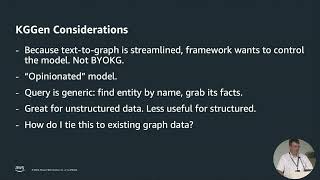
How Knowledge Graphs Help Generative AI Models Answer Questions
Discover how Knowledge Graphs enhance RAG patterns in LLMs, improving accuracy and relationship mapping for more precise AI responses across finance and healthcare applications.
Building Arcane - A Retrieval-Augmented Generation System for Investment Policies
Discover how to build Arcane, a RAG system that revolutionizes policy retrieval in financial institutions, boosting productivity through AI-powered document search and information extraction.
Multimodal RAG with LangChain, VertexAI, Gemini Pro and Chroma
Aprende a construir aplicaciones RAG multimodales utilizando LangChain, VertexAI y Chroma para procesar eficientemente datos no estructurados como PDFs e imágenes.
Multimodal RAG with LlamaIndex, Google AI, Gemini Pro and Qdrant
Explore cómo crear aplicaciones RAG multimodales utilizando LlamaIndex, Google AI Studio SDK y Gemini Pro para extraer información estructurada de imágenes con Qdrant como vector store.
Optimizing RAG Systems for Business Applications
Master the implementation of RAG systems in enterprise settings, from dynamic chunking to custom embedding models, while learning optimization techniques for enhanced AI response accuracy and relevance.
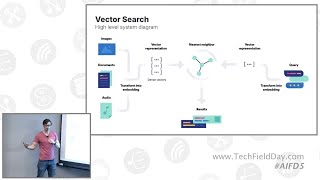
Elasticsearch Vector Database - Introduction to Vector Search and HNSW Algorithm
Dive into Elasticsearch's evolution from a search engine to a powerful vector database, exploring HNSW algorithms, vector compression, and hybrid search capabilities for enhanced data retrieval.
Data Preparation for RAG Applications Using Qdrant and FastEmbed
Master data preparation techniques for RAG applications using Qdrant and FastEmbed, covering chunking methods, embedding generation, indexing strategies, and efficient data loading processes.
Vector Storage for Large Scale Multimodal RAG
Explore advanced vector storage techniques for implementing large-scale multimodal retrieval-augmented generation systems and their practical applications.
Ranking and Retrieval Techniques for RAG Applications with Haystack
Discover how to enhance LLM applications using retrieval and ranking techniques in Haystack, focusing on Lost in the Middle and Diversity Rankers to improve RAG pipeline performance and accuracy.
Evaluating Temporal Persistence of Information Retrieval Models - CLEF 2024 LongEval
Explore how information retrieval systems adapt to evolving web content and search queries, examining temporal performance decline and necessary updates through the LongEval-Retrieval track analysis.
RAG: Nvidia NIM Integration with Langchain for HTML Web Page Parsing
Descubre cómo implementar aplicaciones RAG utilizando Langchain y Nvidia NIM para extraer información de páginas HTML, integrando el modelo Mistral 8 7b Instruct para procesamiento avanzado.
RAG - Parsing HTML Content with BeautifulSoup and Nvidia NIM Integration in LangChain
Dive into building RAG systems by integrating Nvidia NIM with LangChain, using BeautifulSoup for HTML parsing and Mistral 8 7b Instruct as the foundation model.
Leveraging Vector Databases for Advanced Search
Dive into vector databases, embedding techniques, and advanced search algorithms, exploring AWS solutions for implementing efficient vector-based search systems and quantization methods.

Nixiesearch - Building a Serverless Search Engine with Lucene on S3
Explore how Nixiesearch leverages Lucene over S3 to create a simplified, serverless search engine with built-in AI capabilities, including RAG and text+image embeddings for modern search solutions.

Building a GenZ Search Application with LLMs - Search and AI Integration for Student Learning
Discover how Knowunity leverages LLMs to enhance search functionality for Gen Z students, from AI-powered content summarization to intelligent question generation and knowledge graph construction.

Relevance Proof in Yelp Search - LLM-Powered Annotations
Discover how Yelp enhances search results using LLM-powered annotations, focusing on review highlights and business information to improve user experience and search relevance at scale.
Latest Techniques of Entity Matching in Natural Language Processing
Discover practical techniques for entity matching in NLP, from fundamental concepts to advanced industry practices, including solutions for handling real-world data complexities and missing attributes.
A Gentle Introduction to Vector Databases
Explore vector databases, semantic search, and machine learning models for unstructured data processing. Learn about Weaviate and see a practical demo of vector search in action.