Milvus 2.0 - Building the World's Most Advanced Open-Source Vector Database
Explore Milvus 2.0, an advanced open-source vector database. Learn its architecture, layers, and applications in ML pipelines, smart property search, product recommendations, and more.
The Rise of Vector Databases - Lessons from the Milvus Community
Explore vector databases, their rise in managing unstructured data, and insights from Milvus. Learn about embeddings, production use cases, challenges, and future developments in this emerging field.
The Evolution of Milvus - A Cloud-Native Vector Database
Explore Milvus 2.0, a cloud-native vector database for unstructured data. Learn its architecture, features, and real-world applications in art, security, real estate, and e-commerce.
Document Q&A Using LlamaIndex - Building Applications for Unstructured Data Extraction
Master document querying with LlamaIndex, a powerful tool for extracting answers from unstructured data like PDFs, presentations, and images, enabling efficient information retrieval and analysis.
Exploring Vector Search at Scale with Milvus - Building Billion-Scale Solutions
Explore vector search at billion-scale through Milvus, understanding distributed systems architecture, indexing strategies, and scalability solutions for unstructured data processing.
AI Inference Engine for Object Storage Systems
Discover how AI inference capabilities enhance object storage systems by automating metadata generation, enabling advanced object detection, and improving searchability of stored data.

Data Management in the Hybrid Multi-cloud Era - Managing Unstructured Data with Crystal
Discover how to manage unstructured data sprawl across hybrid multi-cloud environments using Crystal, an open-source platform for unified data protection, security, governance, and insights optimization.
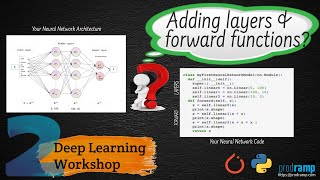
Adding Layers and Forward Functions to Your Neural Network in PyTorch
Learn to create neural networks in PyTorch: design layers, implement forward functions, and adapt models for various data types. Hands-on examples cover basic to complex architectures for structured and unstructured data.
Understanding Unstructured Data with Language Models - Alex Peattie
Explore language models for unstructured data analysis, covering classification, predictive modeling, and information retrieval. Learn key concepts and practical applications in various fields.
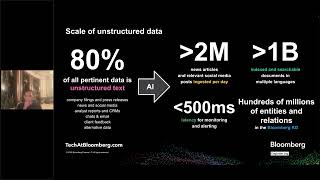
Search and Discovery in News and Research - Dr. Anju Kambadur
Explore Bloomberg's AI-driven search and discovery system for financial news, leveraging machine learning and NLP to parse unstructured data and provide valuable insights for clients.
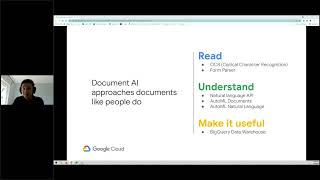
Accelerating the Journey to Document Understanding AI
Unlock document value with AI: transform unstructured data into actionable insights using Vision and NLP. Learn possibilities, capabilities, and implementation strategies for Document AI technology.
Efficient Query Processing for Unstructured Data Using Machine Learning
Explore efficient query processing techniques for unstructured data using machine learning, including proxy scores and clustering methods to accelerate analysis and reduce costs.
ADVANCED Python AI Agent Tutorial - Using RAG
Learn to create an AI agent with RAG capabilities, utilizing various tools for task-specific actions. Explore data querying, agent building, and unstructured data handling in Python.
Data Extraction with LangChain and OpenAI for Machine Learning and Data Science
Extraer información de fuentes no estructuradas utilizando LangChain y OpenAI para aprendizaje automático y ciencia de datos.
Multimodal Q&A RAG Tool with Gemini for Data Science and Machine Learning
Develop a multimodal Q&A RAG tool using Gemini for unstructured data analysis, enhancing data science and machine learning capabilities.
Navigating Unstructured Data - Availability vs Analytics in NoSQL
Explore factors affecting database technology choices, focusing on distributed systems and prioritizing availability vs. analytics in NoSQL environments for unstructured data workloads.
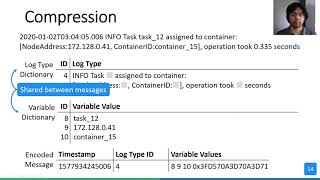
CLP - Efficient and Scalable Search on Compressed Text Logs
Innovative tool for lossless log compression with fast search capabilities, outperforming existing solutions in compression ratio, search speed, and ingestion performance for petabyte-scale log management.
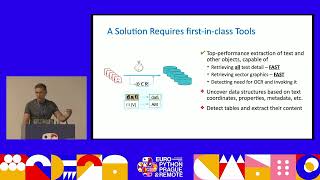
High Volume PDF Text Extraction Using Python Open-Source Tools
Learn efficient techniques for extracting text from large volumes of PDF documents using Python open-source tools, focusing on speed, OCR integration, and detailed information retrieval for business insights.
Data Virtualization - Data Lake Power Using SQL Big Data Cluster
Explore data virtualization with SQL Server 2019 Big Data Cluster, enabling seamless integration of diverse data sources for efficient processing and analysis of structured and unstructured data across cloud and on-premises environments.
Kubernetes and Logging - Do It Right
Explore best practices for logging in Kubernetes environments, covering data processing, metadata correlation, centralization, and reliability. Learn to implement a unified logging layer for effective data analysis.
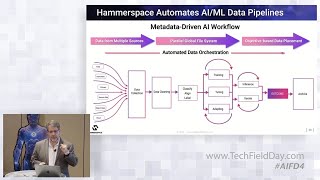
Taming Unstructured Data Orchestration with Hammerspace - Global Data Environment Solutions
Master data orchestration across multi-vendor environments with Hammerspace's Global Data Environment software, enabling seamless management of unstructured data for AI pipelines across distributed storage systems and cloud platforms.